Predictive Maintenance: Fehler erkennen, bevor sie Stillstand kosten
Sensordaten, Regellogik und ML-Modelle im Zusammenspiel: So baut der Mittelstand Predictive Maintenance ohne Hyperscaler auf eigener Infrastruktur.
Von Learoy Eichholz
Das Problem: Stillstand ist teuer, Wartung nach Kalender verschwendet Ressourcen
Ein Fräszentrum steht still. Der Spindelmotor hat Lagerschaden, die Lieferzeit für Ersatz beträgt drei Wochen. In dieser Zeit fehlt Kapazität, Aufträge verschieben sich, Deckungsbeiträge brechen weg. Gleichzeitig wird an anderen Maschinen alle 2.000 Betriebsstunden präventiv getauscht, obwohl die Lager noch 4.000 Stunden Restlaufzeit haben. Beides kostet Geld, beides lässt sich mit Predictive Maintenance verhindern.
Predictive Maintenance bedeutet: Verschleiß und Fehler vorhersagen, bevor sie zum Stillstand führen. Statt starrer Wartungsintervalle analysiert das System kontinuierlich Sensordaten und meldet, wenn tatsächlich Handlungsbedarf besteht. Im deutschen Mittelstand scheitert das oft nicht an der Idee, sondern an der Umsetzung: Sensoren liefern Rohdaten, die niemand auswertet, MES-Systeme speichern Betriebsstunden, aber niemand nutzt sie für Prognosen, und Hyperscaler-Angebote passen weder zur Datenschutzstrategie noch zum Budget.
Dieser Artikel zeigt, wie Sie Predictive Maintenance auf eigener Infrastruktur aufbauen: von der Sensoranbindung über Regellogik bis zu einfachen ML-Modellen, die Anomalien erkennen. Die Beispiele stammen aus Projekten in der Metallverarbeitung und im Maschinenbau, wo Stillstandskosten zwischen 800 und 3.200 Euro pro Stunde liegen.
Welche Daten brauchen Sie wirklich?
Predictive Maintenance beginnt nicht mit einem Modell, sondern mit der Frage: Welche physikalischen Größen zeigen Verschleiß frühzeitig an? Typische Kandidaten in der Produktion:
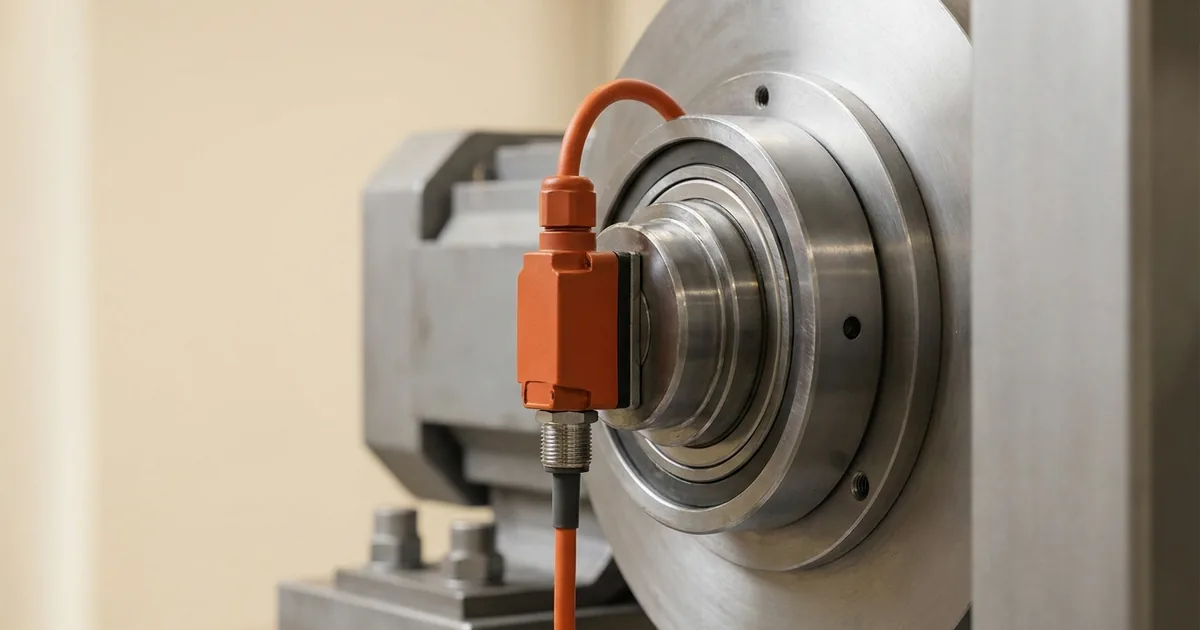
- Vibration: Unwucht, Lagerschäden und Verzahnungsfehler erzeugen charakteristische Frequenzmuster. Ein Beschleunigungssensor am Lagergehäuse liefert Amplituden in x-, y- und z-Richtung. Überschreitet die Effektivamplitude einen Schwellwert oder verschiebt sich das Frequenzspektrum, deutet das auf Verschleiß hin.
- Temperatur: Reibung steigt mit Verschleiß. PT100-Sensoren an Lagern oder Spindeln zeigen schleichende Anstiege, lange bevor ein Totalausfall eintritt. Wichtig: Vergleichen Sie nicht absolute Werte, sondern Trends über mehrere Schichten hinweg.
- Strom: Der Motorstrom steigt, wenn Reibung zunimmt oder Werkzeuge stumpf werden. Ein Stromwandler im Schaltschrank liefert Effektivwerte, die Sie gegen Sollwerte aus dem Anlagenhandbuch oder gegen historische Mittelwerte prüfen.
- Betriebsstunden und Zyklen: Das MES zählt, wie lange eine Maschine läuft und wie viele Teile sie produziert. Diese Daten allein reichen für einfache Regellogik, kombiniert mit Sensordaten werden sie zur Basis für ML-Modelle.
Sie benötigen keine teuren Spezialsensoren. Industrietaugliche Sensoren mit 4 bis 20 mA oder Modbus RTU kosten zwischen 80 und 300 Euro pro Messpunkt. Entscheidend ist, dass die Daten strukturiert in Ihre Pipeline gelangen.
Von der Sensoranbindung zur Pipeline
Die meisten MES-Systeme und SPS speichern Sensordaten zwar, aber nur als Momentaufnahme oder in groben 15-Minuten-Intervallen. Für Predictive Maintenance brauchen Sie höhere Auflösung: Vibrationsdaten alle 100 Millisekunden, Temperatur jede Sekunde, Strom alle 500 Millisekunden. Diese Rohdaten landen zunächst in einem Zeitreihen-Datenspeicher.
Ein typischer Stack im Mittelstand:
- Edge-Gateway: Ein Industrie-PC oder Raspberry Pi mit Modbus-Modul sammelt Sensordaten direkt an der Maschine. Er sendet die Daten über MQTT oder HTTP an einen zentralen Server.
- Zeitreihen-Datenbank: InfluxDB oder TimescaleDB (PostgreSQL-Erweiterung) speichern Millionen Messpunkte effizient. Abfragen wie “Mittelwert der letzten 8 Stunden” dauern Millisekunden.
- Regellogik: Ein Python-Skript oder Node-RED-Flow prüft alle 60 Sekunden, ob Schwellwerte überschritten sind. Bei Überschreitung wird ein Ticket im Wartungssystem angelegt oder eine E-Mail an die Instandhaltung verschickt.
- ML-Modell: Optional trainieren Sie mit historischen Daten ein Anomalie-Erkennungs-Modell, das subtile Musteränderungen erkennt, bevor feste Schwellwerte greifen.
Die Pipeline läuft auf einem Server in Ihrem Rechenzentrum oder bei einem deutschen Hosting-Anbieter. Kosten: 120 bis 350 Euro pro Monat für Hardware, Datenbank und Monitoring.
Regellogik: Der Einstieg ohne Modell
Bevor Sie ein ML-Modell trainieren, starten Sie mit einfacher Regellogik. Sie definieren Schwellwerte auf Basis von Herstellerangaben oder historischen Mittelwerten. Beispiel aus einem Projekt in der Metallverarbeitung:
- Vibration Spindellager: Effektivamplitude über 4,5 mm/s² für mehr als 10 Minuten → Warnung.
- Temperatur Spindellager: Anstieg um mehr als 12 Grad Celsius innerhalb von 2 Stunden → Inspektion einplanen.
- Motorstrom: Abweichung vom Sollwert um mehr als 18 Prozent über 5 Zyklen hinweg → Werkzeugwechsel oder Schmierung prüfen.
Diese Regeln implementieren Sie in wenigen Zeilen Python oder als Node-RED-Flow. Der Vorteil: Sie liefern sofort Nutzen, ohne dass Sie Monate in Datensammlung und Modelltraining investieren. Der Nachteil: Sie erkennen nur bekannte Muster. Schleichende Veränderungen oder unerwartete Kombinationen bleiben unsichtbar.
ML-Modelle für Anomalieerkennung
Sobald Sie mehrere Monate Sensordaten gesammelt haben, trainieren Sie ein Modell, das Normalbetrieb von Anomalien unterscheidet. Zwei Ansätze haben sich im Mittelstand bewährt:
Autoencoder für multivariate Zeitreihen
Ein Autoencoder komprimiert die Eingabedaten in einen latenten Raum und rekonstruiert sie anschließend. Trainiert wird nur auf Daten aus dem Normalbetrieb. Weicht die Rekonstruktion stark vom Original ab, liegt eine Anomalie vor. Beispiel-Architektur in Keras:
from tensorflow.keras.models import Model
from tensorflow.keras.layers import Input, Dense

input_dim = 6  # z.B. Vibration x/y/z, Temperatur, Strom, Drehzahl
encoding_dim = 3

input_layer = Input(shape=(input_dim,))
encoded = Dense(encoding_dim, activation='relu')(input_layer)
decoded = Dense(input_dim, activation='linear')(encoded)

autoencoder = Model(input_layer, decoded)
autoencoder.compile(optimizer='adam', loss='mse')
Sie trainieren das Modell mit Daten aus fehlerfreien Schichten. Im Produktivbetrieb berechnen Sie für jede neue Messung den Rekonstruktionsfehler (MSE). Überschreitet dieser einen Schwellwert, liegt eine Anomalie vor.
Isolation Forest für Ausreißer
Isolation Forest ist ein klassischer ML-Algorithmus, der mit wenig Trainingsdaten auskommt. Er baut Entscheidungsbäume, die Ausreißer schneller isolieren als normale Datenpunkte. Vorteil: Sie benötigen keine langen Normalphasen, sondern können auch mit gemischten Daten arbeiten. Implementierung in scikit-learn:
from sklearn.ensemble import IsolationForest

clf = IsolationForest(contamination=0.02, random_state=42)
clf.fit(X_train)

predictions = clf.predict(X_test)
# -1 bedeutet Anomalie, 1 bedeutet normal
In einem Projekt im Maschinenbau erkannte das Modell Lagerschäden durchschnittlich 14 Tage vor dem Ausfall. Die Instandhaltung konnte Ersatzteile bestellen und den Tausch in eine geplante Wartungspause legen.
Von der Erkennung zur Aktion
Ein Modell, das Anomalien erkennt, ist nutzlos, wenn die Information nicht zur richtigen Person gelangt. Typische Eskalationsketten:
- Info-Stufe: Abweichung unter 15 Prozent → Eintrag im Dashboard, keine Aktion erforderlich.
- Warnung: Abweichung 15 bis 30 Prozent oder Trend über 3 Tage → E-Mail an Instandhaltungsleiter, Inspektion innerhalb von 48 Stunden.
- Alarm: Abweichung über 30 Prozent oder kritischer Schwellwert → SMS an Schichtleiter, sofortige Inspektion, Maschine ggf. herunterfahren.
Die Eskalationslogik implementieren Sie in Ihrer Workflow-Plattform (n8n, Node-RED). Sie lesen die Anomalie-Scores aus der Datenbank, prüfen die Stufe und triggern entsprechende Aktionen: Ticket im CMMS, E-Mail, Slack-Nachricht oder API-Call an das ERP, um Ersatzteile vorzubestellen.
Wichtig: Definieren Sie klare Verantwortlichkeiten. Wenn niemand weiß, wer auf eine Warnung reagiert, verpufft der Nutzen.
Was nicht funktioniert
Drei Fehler, die Projekte verzögern oder scheitern lassen:
- Zu viele Messpunkte: Ein Kunde wollte 120 Sensoren gleichzeitig auswerten. Die Pipeline wurde komplex, die Modelle überfordert, und niemand konnte die Ergebnisse interpretieren. Starten Sie mit 3 bis 5 kritischen Messpunkten an einer Maschine, skalieren Sie später.
- Modell ohne Domänenwissen: Ein Autoencoder erkannte Anomalien, aber die Instandhaltung verstand nicht, warum. Ohne Erklärung sinkt das Vertrauen. Kombinieren Sie ML mit Regellogik und visualisieren Sie, welche Sensoren die Anomalie ausgelöst haben.
- Fehlende Rückkopplung: Sie melden Anomalien, aber niemand protokolliert, ob tatsächlich ein Fehler vorlag. Ohne Feedback können Sie das Modell nicht nachtrainieren und Schwellwerte nicht anpassen. Bauen Sie ein einfaches Ticket-System ein, in dem die Instandhaltung den Ausgang dokumentiert.
Realistische Outcomes
Was bringt Predictive Maintenance konkret? Zahlen aus drei Projekten:
- Metallverarbeitung, 8 Fräszentren: Stillstandszeit durch ungeplante Ausfälle sank von 120 auf 28 Stunden pro Jahr. Ersparnis bei Stillstandskosten von 1.200 Euro pro Stunde: rund 110.000 Euro jährlich.
- Maschinenbau, 4 Drehautomaten: Wartungsintervalle wurden von starr alle 2.000 Stunden auf bedarfsgerecht zwischen 1.800 und 3.200 Stunden angepasst. Ersparnis durch weniger präventive Wechsel: 18.000 Euro pro Jahr.
- Kunststoffverarbeitung, Spritzgussmaschinen: Werkzeugverschleiß wurde 5 bis 9 Tage früher erkannt. Ausschuss sank um 12 Prozent, was bei 80.000 Teilen pro Monat rund 22.000 Euro Materialkosten spart.
Die Amortisationszeit liegt typisch zwischen 9 und 18 Monaten, abhängig von Stillstandskosten und Anzahl der überwachten Maschinen.
Nächste Schritte
Wenn Sie Predictive Maintenance aufbauen möchten, beginnen Sie mit einem Piloten: Wählen Sie eine Maschine mit hohen Stillstandskosten, identifizieren Sie 3 bis 5 kritische Messpunkte und bauen Sie eine einfache Regellogik. Sammeln Sie 8 bis 12 Wochen Daten, verfeinern Sie Schwellwerte und trainieren Sie anschließend ein erstes Anomalie-Modell. Dokumentieren Sie jeden Vorfall, um das System kontinuierlich zu verbessern.
Falls Sie Unterstützung bei Sensorauswahl, Pipeline-Architektur oder Modelltraining benötigen, sprechen Sie mit uns.
Sprechen Sie mit uns
Sie möchten das in Ihrem Betrieb umsetzen? Wir bauen die passende Maschine mit Ihnen.
Telefon: 040 468 967 680
E-Mail: info@whitefox-automations.com
Oder über unser Kontaktformular.
Wenn Sie das praktisch umsetzen wollen
Auch interessant
- 23. Juli 2026 8 Min. Lesezeit
MES-Daten auswerten statt nur speichern: Produktion mit KI steuern
Weiterlesen - 3. Sept. 2026 8 Min. Lesezeit
MES-Integration: Produktionsdaten nahtlos in Ihre Pipeline
Weiterlesen - 6. Aug. 2026 8 Min. Lesezeit
IoT-Daten-Pipelines in der Produktion: Vom Sensor zur Steuerung
Weiterlesen


